- Une exploration qui suit le robot
- 124 contrôles en 19 familles
- Un plan de correction qui se vide
- Journal des 404 et redirections
- Adresses sans identifiant, robots.txt et flux RSS
- Tableau de bord, exports et rapport client
- Explorations planifiées, multiboutique et droits
- Le module modifie-t-il mes pages ou mon contenu ?
- Faut-il un compte Google ou une clé API ?
- Le module mesure-t-il les Core Web Vitals ?
- Combien de temps dure une exploration ?
- Le module fonctionne-t-il en multiboutique ?
- Le robots.txt peut-il être écrasé par PrestaShop ?
- Que se passe-t-il si la licence expire ?
- Mes redirections et mon robots.txt sont-ils conservés à la désinstallation ?
- Le module génère-t-il des balises meta ou des données structurées ?
- Dans quelles langues le module est-il disponible ?
Audit SEO complet de la boutique PrestaShop : erreurs, liens morts et plan de correction
Un lien mort ne prévient pas. Une balise canonique pointée vers une adresse qui n’existe plus non plus. Entre les fiches produit, les catégories, les marques, les pages CMS et les articles, une boutique PrestaShop compte vite des centaines d’adresses, et les erreurs qui gênent les moteurs de recherche se cachent dans le code des pages, pas à l’écran.
Erreurs SEO explore la boutique comme un robot de moteur de recherche, classe chaque anomalie par gravité et par impact, puis propose de la corriger dans le même back-office : journal des 404, redirections, adresses sans identifiant, robots.txt, flux RSS. Le plan de correction se vide au fil des explorations, et le rapport client reprend ce qui reste à faire.
Le module constate et répare ; vous décidez de l’ordre. Aucune page, aucune balise meta et aucun texte n’est réécrit automatiquement.
Points forts :
- L’exploration : accueil, sitemap, liens internes et catalogue, en HTML servi, une exploration par boutique et par langue
- Les contrôles : 124 points en 19 familles, avec la page et l’élément concernés
- Le plan de correction : gravité, impact, effort, statut, notes et historique, priorisé par le trafic
- Les réparations : journal des 404, redirections, adresses sans identifiant et robots.txt
- Le partage : tableau de bord, exports CSV et JSON, rapport client imprimable, explorations planifiées
Découvrir le module et ses formules
Présentation
Le référencement d’une boutique ne se joue pas seulement sur les mots-clés. Il se joue sur des détails techniques : une page qui répond en 404, deux adresses qui affichent le même contenu, une balise canonique qui désigne une adresse obsolète, un titre dupliqué, une image sans texte alternatif, un robots.txt qui bloque une catégorie utile. Ces défauts ne se voient pas dans le back-office, et les trouver à la main demande de lire le code de chaque page.
Le module reprend ce travail. Il explore la boutique en suivant les liens, comme le ferait un robot, et enregistre chaque anomalie avec sa gravité, l’adresse et l’élément concernés. Les constats sont ensuite rangés dans un plan de correction unique, avec les outils pour traiter les causes les plus fréquentes : les 404, les redirections, les adresses sans identifiant et le robots.txt.
Il s’adresse aux marchands qui veulent savoir ce qui cloche sans ouvrir la console du navigateur, aux agences qui auditent une boutique avant de la corriger, et aux propriétaires de plusieurs boutiques qui ont besoin d’un suivi par boutique et par langue. Aucun compte externe et aucune clé API ne sont nécessaires.
Le module n’écrit pas dans vos pages. Il n’ajoute aucun fichier CSS ou JavaScript à la vitrine ; les adresses sans identifiant remplacent les adresses de PrestaShop, et les redirections sont servies avant le rendu de la page.
Fonctionnalités
Une exploration qui suit le robot
L’exploration part de l’accueil, du sitemap, des liens internes et du catalogue. Elle lit le HTML tel qu’il est servi, sans exécuter JavaScript : les contenus ajoutés côté navigateur ne sont donc pas vus, ce qui correspond à ce qu’un robot reçoit. Les redirections ne sont pas suivies pendant l’exploration, pour pouvoir les signaler. Seules les pages des hôtes de la boutique sont explorées, et les adresses privées ou réservées sont refusées ; les liens externes ne sont vérifiés que si l’option est activée.
Une exploration est faite par boutique et par langue, avec un historique daté et une comparaison avec la précédente : ce qui est nouveau, corrigé, toujours présent ou revenu. Une exploration peut être mise en pause, reprise ou annulée, et le module reprend là où il s’était arrêté. Sans tâche planifiée, l’exploration avance tant que la page du module reste ouverte.
124 contrôles en 19 familles
Chaque anomalie appartient à une famille, ce qui permet de lire le plan par thème plutôt que comme une liste :
- Liens et redirections : liens morts, chaînes et boucles.
- Liens externes : liens sortants cassés ou injoignables.
- Indexabilité : balises et en-têtes qui tiennent une page hors de l’index.
- URL canoniques et variantes : adresses en double, paramètres, casse et barre finale.
- HTTPS et domaine : contenu mixte, références HTTP, ports et doublons de domaine.
- Titres, descriptions et intertitres : longueur, unicité et présence.
- Contenu dupliqué et pauvre : similarité entre pages et contenu trop court.
- Images : textes alternatifs et attributs des images.
- Données structurées : JSON-LD.
- Balises sociales : Open Graph et Twitter Cards.
- Hreflang et langues : alternatives de langue, codes et retours.
- Sitemap : présence, cohérence et adresses.
- robots.txt : règles et blocages.
- Indicateurs de performance HTML : poids et nombre d’éléments de la page, pas les Core Web Vitals.
- Maillage interne : liens internes et façon dont les pages se connectent.
- Contenu et lisibilité : phrases, paragraphes et mots-clés.
- Journal des 404 : adresses encore demandées et non traitées.
- Règles de redirection : boucles, chaînes et cibles inexistantes.
- Flux RSS : validité du flux.
Les seuils se règlent dans la configuration : longueur des titres et des descriptions, taux de similarité entre deux pages, nombre de mots sous lequel une page est considérée comme pauvre.
Un plan de correction qui se vide
Chaque anomalie reçoit une gravité — critique, importante ou mineure —, un impact, un effort, la page et l’élément concernés, un statut (à corriger, en cours, corrigée, ignorée), des notes et un historique. Le score de priorité augmente avec le trafic de la page, importé depuis un export CSV de Search Console : les erreurs qui touchent les pages les plus visitées remontent en premier.
Le plan se filtre par gravité, par famille, par statut et par page. Une anomalie peut être ignorée, et des règles d’ignorance évitent de la revoir à chaque exploration. L’exploration suivante vérifie le correctif : une anomalie qui a disparu passe à « corrigée », une anomalie qui revient se rouvre.
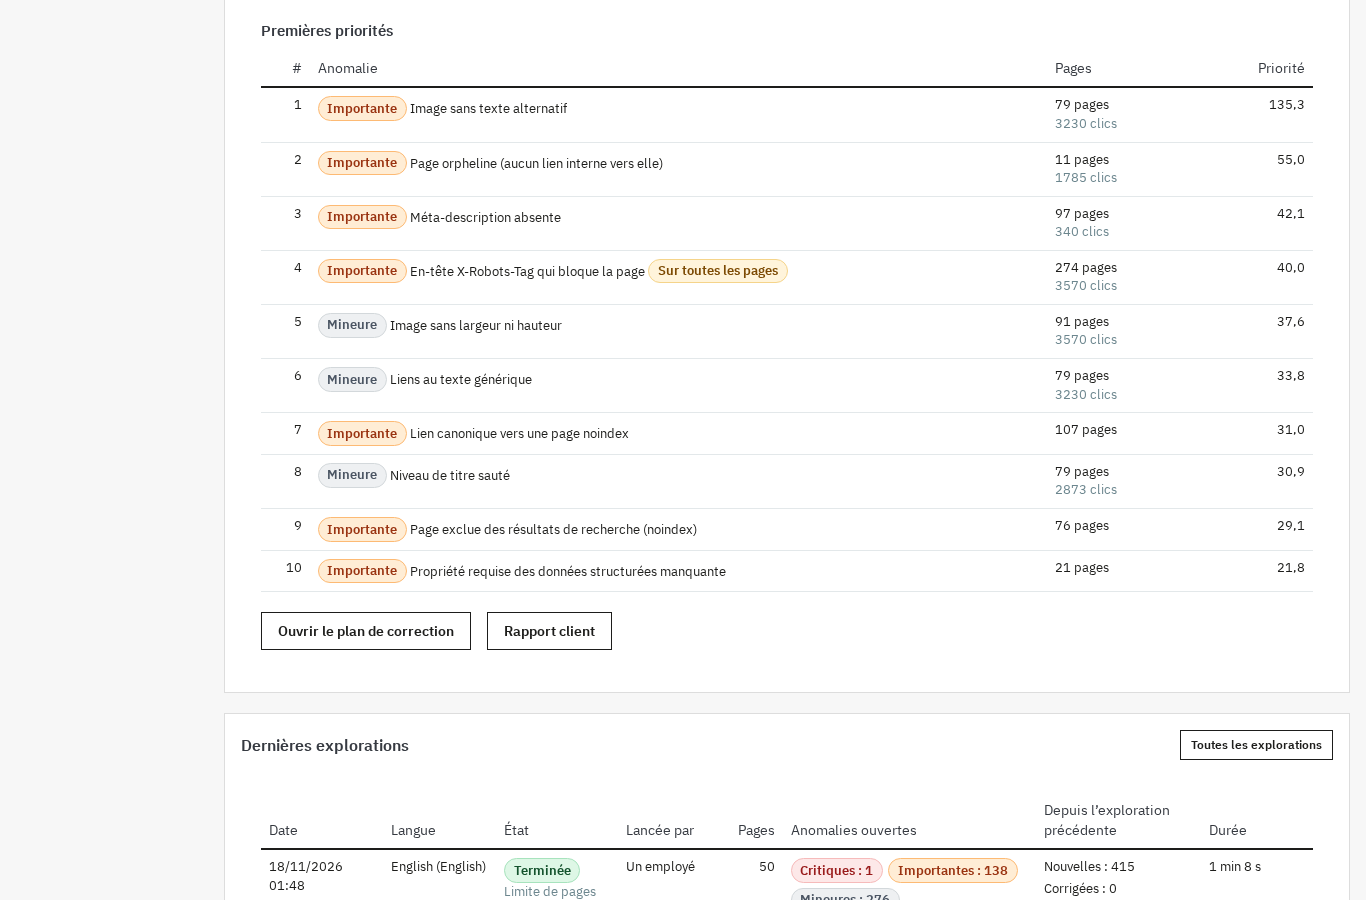 Les erreurs classées par priorité, avec la gravité, le nombre de pages et les clics de chaque page
Journal des 404 et redirections
Le journal des 404 enregistre les adresses demandées qui n’existent pas, sans conserver l’adresse IP du visiteur, et suggère une page proche pour chaque adresse. Une redirection se crée en un clic depuis le journal ; une adresse sans cible utile peut être ignorée.
Le gestionnaire de redirections accepte des règles exactes et des expressions régulières, en 301, 302 ou 303, avec des priorités et un contrôle des boucles et des chaînes. Les règles s’importent et s’exportent en CSV, et sont servies avant le rendu de la page.
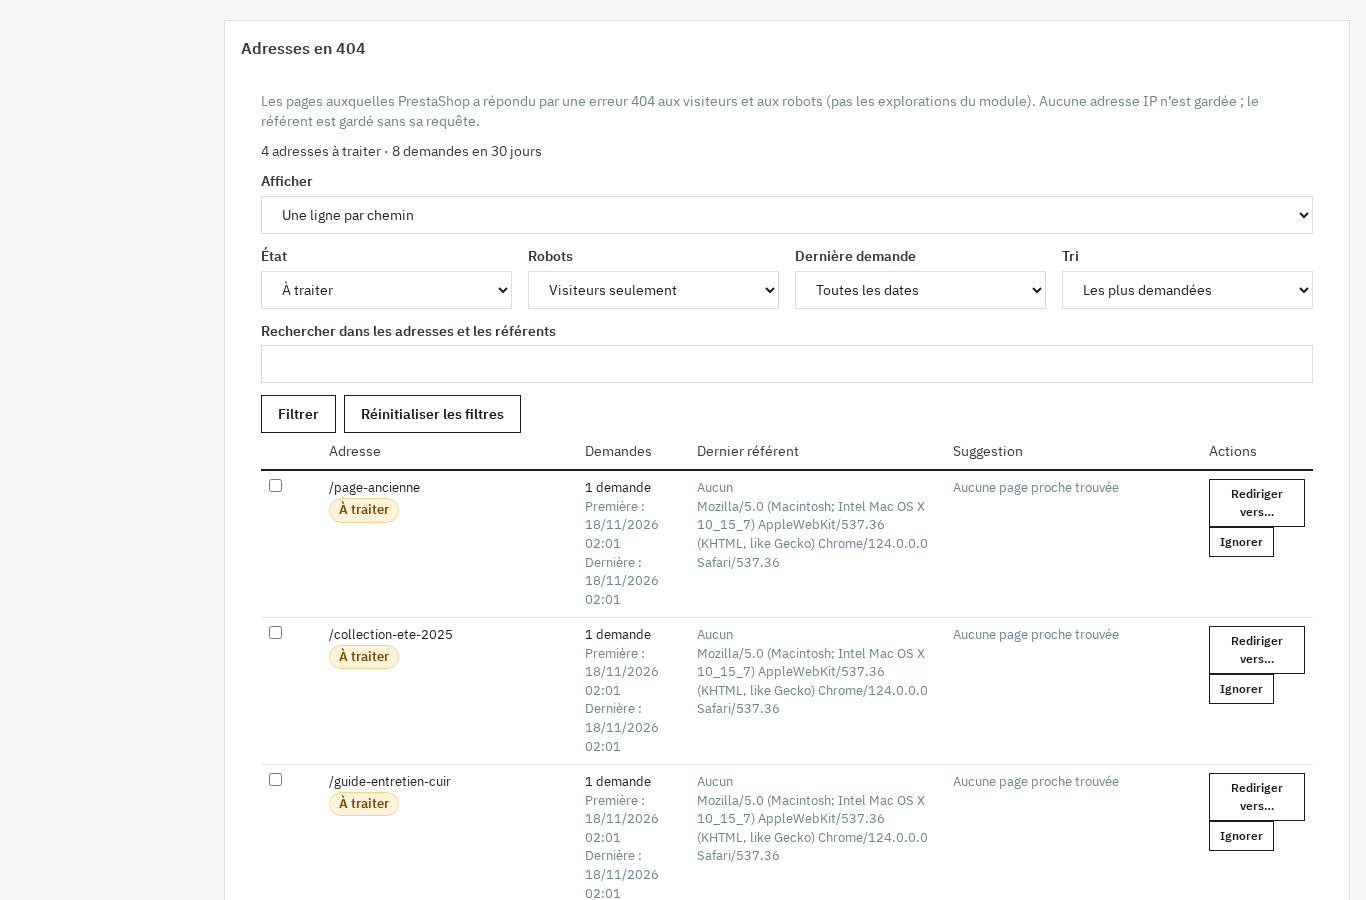 Les adresses en 404 deviennent des redirections utiles en quelques clics
Adresses sans identifiant, robots.txt et flux RSS
Pour les produits, les catégories, les marques et les pages CMS, le module propose des adresses sans identifiant, plus lisibles pour les visiteurs et les moteurs. Une simulation affiche les collisions avant l’application, un contrôle en direct vérifie le résultat, les anciennes adresses répondent en 301 et une restauration remet la configuration d’origine des adresses ; le robots.txt n’est pas restauré.
L’éditeur de robots.txt affiche un aperçu, teste une adresse face aux règles, conserve des versions et permet de revenir à une précédente. Le fichier est partagé par toutes les boutiques : si PrestaShop le régénère, le module le détecte et propose de restaurer votre version.
Le flux RSS des nouveautés publie les nouveaux contenus par langue, avec un en-tête de cache et une réponse 304 pour les visiteurs qui n’ont rien de neuf à lire. Il est désactivé par défaut.
Tableau de bord, exports et rapport client
Le tableau de bord résume la dernière exploration de chaque langue : compteurs par gravité et par famille, premières priorités, évolution des douze dernières explorations et alertes. Les anomalies s’exportent en CSV ou en JSON.
Le rapport client se génère dans la langue du rapport, avec votre logo, et s’imprime ou s’enregistre en PDF. Il reprend le résumé, les anomalies ouvertes par gravité, le tableau par famille et les priorités.
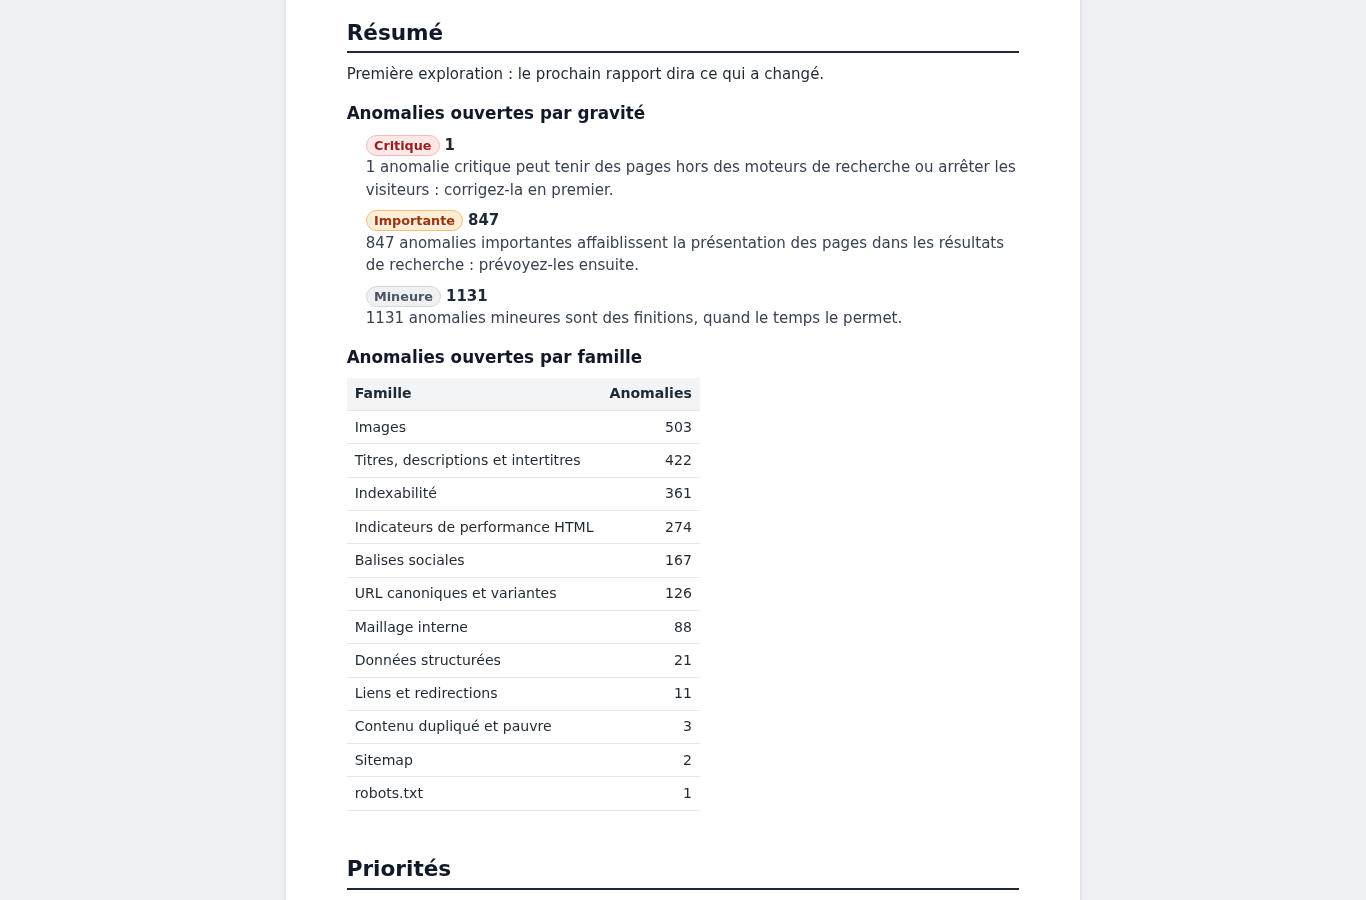 Le rapport client résume les anomalies par gravité et par famille, prêt à imprimer
Explorations planifiées, multiboutique et droits
Une tâche planifiée lance les explorations chaque jour, chaque semaine ou chaque mois, dans le fuseau horaire de la boutique, et envoie le rapport par e-mail. Le jeton de la tâche et les identifiants HTTP d’une boutique protégée ne sont jamais réaffichés en clair.
En multiboutique, chaque boutique et chaque langue a son exploration, son historique et ses réglages ; les boutiques d’un groupe se comparent dans une vue dédiée. Trois droits séparent la consultation, la gestion et les données, et chaque action est vérifiée sur le serveur.
Installation
- Téléchargez l’archive du module et installez-la depuis Modules > Gestionnaire de modules, ou déposez le dossier
wepresta_seo_auditdans le répertoiremodulesde la boutique. - Installez le module. L’installation crée les tables du module et son entrée de menu.
- Ouvrez la page de configuration et activez votre licence. Sans licence valide, le module se désactive et ne sert ni redirections ni journal des 404.
- Ouvrez le module depuis le menu Modules ou, selon votre version, depuis le menu WePresta.
Le module n’ajoute aucun fichier CSS ou JavaScript à la vitrine. Il sert les redirections, les adresses sans identifiant, le journal des 404 et le flux RSS depuis la boutique, sans modifier le thème.
Première configuration
- État : vérifiez la licence et activez le module.
- Exploration : choisissez la profondeur, le plafond de pages, le délai entre deux requêtes, le délai d’attente et la concurrence. Les valeurs par défaut explorent jusqu’à 2 000 pages, avec 250 ms entre deux requêtes et deux requêtes simultanées.
- Seuils : ajustez la longueur des titres et des descriptions, le taux de similarité et le nombre de mots sous lequel une page est jugée pauvre.
- Lancez une première exploration depuis la page Exploration. Suivez son avancement, puis ouvrez le plan de correction.
- Trafic : importez un export CSV de Search Console pour classer les priorités par clics. Les en-têtes attendus sont pré-remplis.
- Planification : activez une exploration quotidienne, hebdomadaire ou mensuelle et le rapport par e-mail. Sans tâche planifiée, l’exploration continue seulement tant que la page du module reste ouverte.
La page de configuration regroupe aussi les sections Journal des 404, Redirections, Flux RSS, Rapport client et Données. Le journal des 404 et les redirections sont actifs par défaut ; le flux RSS est désactivé.
Utilisation au quotidien
Le matin. Ouvrez le tableau de bord : les priorités de la dernière exploration sont classées par score. Traitez d’abord les critiques et les pages qui reçoivent des clics.
Après une mise à jour du catalogue. Relancez une exploration. La comparaison avec la précédente montre ce qui est nouveau, ce qui est corrigé et ce qui revient ; le plan se met à jour sans perdre les statuts ni les notes.
Quand une adresse tombe. Le journal des 404 la signale avec une cible suggérée. Créez la redirection, puis vérifiez qu’elle est bien servie.
Pour un client. Générez le rapport client dans sa langue, avec votre logo, et imprimez-le ou enregistrez-le en PDF. Il montre les anomalies par gravité et par famille, pas seulement une liste de pages.
En multiboutique. Chaque boutique a ses explorations et ses réglages. La vue de comparaison met les boutiques du groupe côte à côte.
Cas d’usage
Boutique qui change de thème ou d’adresses. Une refonte déplace des catégories et des fiches produit. L’exploration signale les 404 et les liens morts, le gestionnaire de redirections reprend les anciennes adresses et les adresses sans identifiant rendent les nouvelles plus lisibles.
Catalogue important. Des milliers de fiches produisent des titres dupliqués, des images sans texte alternatif et des descriptions trop courtes. Le plan classe ces anomalies par famille et par gravité, et les règles d’ignorance évitent de traiter à la main ce qui est assumé.
Agence ou consultant. L’exploration datée, la comparaison et le rapport client documentent l’état initial, les corrections et ce qui reste. Le rapport se génère dans la langue du client.
Boutique multilingue et multiboutique. Chaque langue a son exploration et ses adresses. La comparaison entre boutiques montre où les mêmes erreurs reviennent.
Prérequis et limites
- PrestaShop 1.7.8, 8.2+ et 9.0+ ; les versions 8.0 et 8.1 ne sont pas prises en charge. PHP 7.4 ou plus récent.
- L’exploration lit le HTML servi, sans JavaScript : les contenus et les liens ajoutés côté navigateur ne sont pas vus.
- Avec les réglages par défaut, comptez environ 1 000 pages en 10 à 20 minutes ; le plafond par défaut est de 2 000 pages par exploration. Sans tâche planifiée, l’exploration avance seulement tant que la page du module reste ouverte.
- Les indicateurs de performance sont calculés sur le HTML, pas sur les Core Web Vitals.
- Les liens externes ne sont pas vérifiés par défaut ; l’option existe, mais allonge l’exploration et sort du domaine de la boutique. Seuls les hôtes de la boutique sont explorés.
- Le module ne génère ni balises meta, ni données structurées, ni sitemap, et ne réécrit pas les textes alternatifs : il les contrôle et indique quoi corriger.
- Le robots.txt est partagé par toutes les boutiques. PrestaShop peut le régénérer depuis son propre outil ; le module détecte l’écrasement et propose de restaurer votre version, mais ne peut pas l’empêcher.
- Sans licence valide, le module se désactive : les redirections ne sont plus servies, le journal des 404 s’arrête, les adresses sans identifiant reviennent au format de PrestaShop et le flux RSS répond en 404. Les données sont conservées et tout revient à la validation de la licence.
- À la désinstallation, les données sont supprimées si vous cochez l’option prévue ; les lignes
PS_ROUTE_*mises de côté sont remises en place et le robots.txt n’est pas modifié.
FAQ
Le module modifie-t-il mes pages ou mon contenu ?
Non. Il lit le HTML tel qu’il est servi et n’écrit jamais dans les pages, les fiches produit ou les catégories. Ses seules écritures concernent le journal des 404, les règles de redirection, la configuration des adresses, le robots.txt et le flux RSS ; aucune page n’est modifiée. Aucune balise meta et aucun texte n’est réécrit automatiquement.
Faut-il un compte Google ou une clé API ?
Non. Aucun compte externe et aucune clé API ne sont nécessaires. La priorisation par le trafic utilise un export CSV de Search Console que vous importez ; les en-têtes attendus sont pré-remplis.
Le module mesure-t-il les Core Web Vitals ?
Non. La famille « Indicateurs de performance HTML » regarde ce que la page contient et son poids, pas les mesures de terrain de Google. Les Core Web Vitals et la vitesse réelle demandent un outil dédié ; le module signale en revanche les pages lourdes et les éléments qui pèsent.
Combien de temps dure une exploration ?
Avec les réglages par défaut, comptez environ 1 000 pages en 10 à 20 minutes, dans la limite par défaut de 2 000 pages. Sans tâche planifiée, l’exploration continue tant que la page du module reste ouverte ; avec la tâche planifiée, elle avance en arrière-plan. Le délai entre deux requêtes et la concurrence se règlent.
Le module fonctionne-t-il en multiboutique ?
Oui. Une exploration est faite par boutique et par langue, avec son historique et sa comparaison. Les boutiques d’un groupe se comparent dans une vue dédiée, et les réglages d’exploration appartiennent à chaque boutique.
Le robots.txt peut-il être écrasé par PrestaShop ?
Oui. Le fichier est partagé par toutes les boutiques, et l’outil de génération de PrestaShop peut le réécrire. Le module détecte l’écrasement et propose de restaurer la dernière version enregistrée ; il ne peut pas empêcher la régénération.
Que se passe-t-il si la licence expire ?
Le module se désactive dans les boutiques concernées : les redirections ne sont plus servies, le journal des 404 s’arrête, les adresses sans identifiant reviennent au format de PrestaShop et le flux RSS répond en 404. Les tables, les réglages et les données restent en place, et tout revient à la validation de la licence.
Mes redirections et mon robots.txt sont-ils conservés à la désinstallation ?
Les lignes PS_ROUTE_* mises de côté sont remises en place et le robots.txt n’est pas modifié. Les tables et les réglages du module sont supprimés seulement si vous cochez l’option de suppression des données ; sinon ils restent en place.
Le module génère-t-il des balises meta ou des données structurées ?
Non. Il contrôle les balises existantes et signale les manques, mais ne génère ni titres, ni descriptions, ni JSON-LD, ni sitemap. Ces éléments sont couverts par des modules complémentaires de la même gamme, comme SEO Meta Automator et Schema Pro.
Dans quelles langues le module est-il disponible ?
L’interface, le plan de correction et le rapport par e-mail existent en français, anglais, espagnol, italien et polonais. Le rapport client se génère dans la langue du rapport, et une boutique multilingue a une exploration par langue.
Support
Pour toute aide, contactez-nous depuis votre espace client ou par e-mail à mail@wepresta.shop, selon l’option de support de votre formule.
Avant de nous écrire, préparez :
- la version de PrestaShop et de PHP ;
- la version du module ;
- l’adresse concernée ou le nom de l’écran ;
- une capture de l’écran et le message exact.
Changelog
Version 1.0.0
- Explore la boutique comme un robot : accueil, sitemap, liens internes et catalogue, en HTML servi, sans JavaScript.
- Lance une exploration par boutique et par langue, avec historique daté et comparaison : nouvelles anomalies, corrigées, persistantes, réapparues.
- Contrôle 124 points SEO en 19 familles, avec la page et l’élément concernés.
- Classe les anomalies dans un plan de correction avec gravité, impact, effort, statut, notes et historique, et vérifie le correctif à l’exploration suivante.
- Priorise le plan avec le trafic importé depuis un export CSV de Search Console.
- Enregistre les 404 sans adresse IP, suggère une cible et crée la redirection en un clic.
- Gère des redirections exactes et par expression régulière, en 301, 302 ou 303, avec priorités, contrôle des boucles et des chaînes, import et export CSV.
- Propose des adresses sans identifiant pour produits, catégories, marques et pages CMS, avec simulation, contrôle des collisions, 301 depuis les anciennes adresses et restauration.
- Édite le robots.txt avec testeur, aperçu, versions et restauration.
- Publie un flux RSS des nouveautés par langue.
- Affiche un tableau de bord, des exports CSV et JSON et un rapport client imprimable dans la langue du rapport.
- Planifie les explorations chaque jour, chaque semaine ou chaque mois, avec rapport par e-mail.
- Gère le multiboutique, la comparaison des boutiques et les droits par employé.
- Fournit l’interface en cinq langues.

Articles liés
Audit SEO PrestaShop : erreurs 404, liens cassés et plan de correction
Le module Erreurs SEO explore la boutique en HTML servi, classe les anomalies par gravité et par trafic, puis traite les 404, les redirections, les adresses et le…