- Skanowanie, które podąża za robotem
- 124 kontrole w 19 rodzinach
- Plan naprawy, który się opróżnia
- Dziennik błędów 404 i przekierowania
- Adresy bez identyfikatora, robots.txt i kanał RSS
- Pulpit, eksporty i raport dla klienta
- Zaplanowane skanowania, multisklep i uprawnienia
- Czy moduł zmienia moje strony lub treści?
- Czy potrzebne jest konto Google lub klucz API?
- Czy moduł mierzy Core Web Vitals?
- Ile trwa skanowanie?
- Czy moduł działa w multisklepie?
- Czy PrestaShop może nadpisać robots.txt?
- Co się stanie, gdy licencja wygaśnie?
- Czy przekierowania i robots.txt zostają po odinstalowaniu?
- Czy moduł generuje meta tagi lub dane strukturalne?
- W jakich językach jest dostępny?
Pełny audyt SEO sklepu PrestaShop: błędy, martwe linki i plan naprawy
Martwy link nie ostrzega. Adres kanoniczny wskazujący na stronę, która już nie istnieje, też nie. Między kartami produktów, kategoriami, markami, stronami CMS i artykułami sklep PrestaShop szybko zbiera setki adresów, a błędy, które przeszkadzają wyszukiwarkom, ukrywają się w kodzie stron, nie na ekranie.
Błędy SEO skanuje sklep jak robot wyszukiwarki, porządkuje każdy problem według wagi i wpływu, a potem pomaga go naprawić w tym samym panelu: dziennik błędów 404, przekierowania, adresy bez identyfikatora, robots.txt i kanał RSS. Plan naprawy opróżnia się z każdym skanowaniem, a raport dla klienta pokazuje, co zostało.
Moduł wykrywa i naprawia; o kolejności decydujesz ty. Żadna strona, meta tag ani tekst nie jest przepisywany automatycznie.
Najważniejsze:
- Skanowanie: strona główna, sitemap, linki wewnętrzne i katalog, w serwowanym HTML, jedno skanowanie na sklep i język
- Kontrole: 124 punkty w 19 rodzinach, ze stroną i elementem, którego dotyczą
- Plan naprawy: waga, wpływ, nakład, status, notatki i historia, uporządkowany według ruchu
- Naprawy: dziennik błędów 404, przekierowania, adresy bez identyfikatora i robots.txt
- Udostępnianie: pulpit, eksporty CSV i JSON, raport dla klienta do wydruku, zaplanowane skanowania
Prezentacja
SEO sklepu to nie tylko słowa kluczowe. To także szczegóły techniczne: strona, która odpowiada 404, dwa adresy pokazujące tę samą treść, adres kanoniczny wskazujący na nieaktualny adres, powtórzony tytuł, obraz bez tekstu alternatywnego, robots.txt blokujący przydatną kategorię. Niczego z tego nie widać w panelu administracyjnym, a ręczne znalezienie wymaga czytania kodu każdej strony.
Moduł przejmuje tę pracę. Skanuje sklep, podążając za linkami jak robot, i zapisuje każdy problem z wagą, adresem i elementem, którego dotyczy. Wyniki trafiają do jednego planu naprawy, obok narzędzi rozwiązujących najczęstsze przyczyny: błędy 404, przekierowania, adresy bez identyfikatora i robots.txt.
Moduł jest dla sklepów, które chcą wiedzieć, co nie działa, bez otwierania konsoli przeglądarki, dla agencji, które audytują sklep przed naprawą, oraz dla właścicieli kilku sklepów, którzy potrzebują kontroli dla każdego sklepu i języka. Nie wymaga konta zewnętrznego ani klucza API.
Moduł nie zapisuje w stronach. Nie dodaje plików CSS ani JavaScriptu do witryny; adresy bez identyfikatora zastępują adresy PrestaShop, a przekierowania są serwowane przed wyrenderowaniem strony.
Funkcje
Skanowanie, które podąża za robotem
Skanowanie startuje ze strony głównej, sitemapy, linków wewnętrznych i katalogu. Czyta HTML w postaci serwowanej, bez uruchamiania JavaScriptu: treści dodawane w przeglądarce nie są widoczne, czyli dokładnie tak, jak odbiera je robot. Przekierowania nie są śledzone podczas skanowania, żeby można było je zgłosić. Skanowane są tylko strony na hostach sklepu, a adresy prywatne i zarezerwowane są odrzucane; linki zewnętrzne są sprawdzane tylko po włączeniu opcji.
Skanowanie odbywa się dla każdego sklepu i języka, z datowaną historią i porównaniem z poprzednim: co jest nowe, naprawione, wciąż obecne albo wróciło. Skanowanie można wstrzymać, wznowić lub anulować, a moduł kontynuuje od miejsca, w którym się zatrzymał. Bez zadania zaplanowanego skanowanie posuwa się tylko dopóki strona modułu pozostaje otwarta.
124 kontrole w 19 rodzinach
Każdy problem należy do jednej rodziny, dzięki czemu plan czyta się tematycznie, a nie jako jedną długą listę:
- Linki i przekierowania: martwe linki, łańcuchy i pętle.
- Linki zewnętrzne: niedziałające lub nieosiągalne linki wychodzące.
- Indeksowalność: tagi i nagłówki, które trzymają stronę poza indeksem.
- Adresy kanoniczne i warianty: zduplikowane adresy, parametry, wielkość liter i końcowy ukośnik.
- HTTPS i domena: mieszana treść, odwołania HTTP, porty i zduplikowane hosty.
- Tytuły, opisy i nagłówki: długość, unikalność i obecność.
- Zduplikowana i uboga treść: podobieństwo stron i zbyt krótka treść.
- Obrazy: teksty alternatywne i atrybuty obrazów.
- Dane strukturalne: JSON-LD.
- Tagi społecznościowe: Open Graph i Twitter Cards.
- Hreflang i języki: warianty językowe, kody i linki zwrotne.
- Sitemap: obecność, spójność i adresy.
- robots.txt: reguły i blokady.
- Wskaźniki wydajności HTML: waga i liczba elementów strony, nie Core Web Vitals.
- Linkowanie wewnętrzne: linki wewnętrzne i sposób łączenia stron.
- Treść i czytelność: zdania, akapity i słowa kluczowe.
- Dziennik błędów 404: adresy nadal żądane i nieobsłużone.
- Reguły przekierowań: pętle, łańcuchy i nieistniejące cele.
- Kanał RSS: poprawność kanału.
Progi ustawia się w konfiguracji: długość tytułów i opisów, poziom podobieństwa dwóch stron oraz liczbę słów, poniżej której strona jest uznawana za ubogą.
Plan naprawy, który się opróżnia
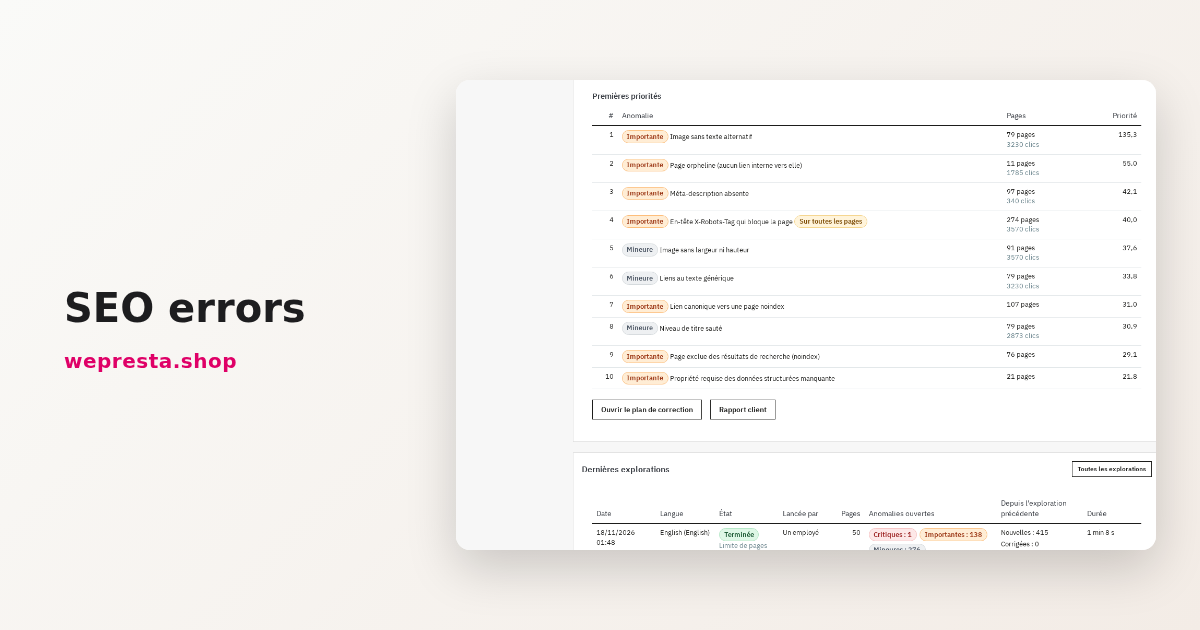
Każdy problem otrzymuje wagę — krytyczny, ważny lub drobny —, wpływ, nakład, stronę i element, status (do naprawy, w toku, naprawiony, zignorowany), notatki i historię. Wynik priorytetu rośnie wraz z ruchem strony, importowanym z pliku CSV Search Console: problemy dotyczące najczęściej odwiedzanych stron idą pierwsze.
Plan filtruje się według wagi, rodziny, statusu i strony. Problem można zignorować, a reguły wykluczeń chronią przed jego powracaniem przy każdym skanowaniu. Kolejne skanowanie sprawdza poprawkę: problem, który zniknął, przechodzi na naprawiony, a ten, który wrócił, otwiera się ponownie.
Dziennik błędów 404 i przekierowania
Dziennik błędów 404 zapisuje żądane adresy, które nie istnieją, bez przechowywania adresu IP odwiedzającego, i sugeruje pobliską stronę dla każdego adresu. Przekierowanie tworzy się jednym kliknięciem z dziennika; adres bez użytecznego celu można zignorować.
Menedżer przekierowań przyjmuje reguły dokładne i wyrażenia regularne, w 301, 302 lub 303, z priorytetami i kontrolą pętli oraz łańcuchów. Reguły można importować i eksportować w CSV, a są serwowane przed wyrenderowaniem strony.
Adresy bez identyfikatora, robots.txt i kanał RSS
Dla produktów, kategorii, marek i stron CMS moduł oferuje adresy bez identyfikatora, czytelniejsze dla odwiedzających i wyszukiwarek. Symulacja pokazuje kolizje przed zastosowaniem, kontrola na żywo weryfikuje wynik, stare adresy odpowiadają przekierowaniem 301, a przywrócenie wraca do pierwotnej konfiguracji adresów; robots.txt nie jest przywracany.
Edytor robots.txt pokazuje podgląd, testuje adres względem reguł, zachowuje wersje i pozwala wrócić do poprzedniej. Plik jest wspólny dla wszystkich sklepów: jeśli PrestaShop go wygeneruje ponownie, moduł to wykrywa i proponuje przywrócenie twojej wersji.
Kanał RSS nowości publikuje nowe treści w każdym języku, z nagłówkiem pamięci podręcznej i odpowiedzią 304 dla odwiedzających, którzy nie mają nic nowego do przeczytania. Na start jest wyłączony.
Pulpit, eksporty i raport dla klienta
Pulpit podsumowuje ostatnie skanowanie każdego języka: liczniki według wagi i rodziny, pierwsze priorytety, zmianę dwunastu ostatnich skanowań i alerty. Problemy można wyeksportować do CSV lub JSON.
Raport dla klienta powstaje w języku raportu, z twoim logo, i można go wydrukować lub zapisać w PDF. Zawiera podsumowanie, otwarte problemy według wagi, tabelę według rodzin i priorytety.
Zaplanowane skanowania, multisklep i uprawnienia
Zadanie zaplanowane uruchamia skanowania codziennie, co tydzień lub co miesiąc, w strefie czasowej sklepu, i wysyła raport e-mailem. Token zadania i dane HTTP chronionego sklepu nigdy nie są ponownie pokazywane jawnie.
W multisklepie każdy sklep i każdy język ma własne skanowanie, historię i ustawienia; sklepy w grupie można porównywać w osobnym widoku. Trzy uprawnienia rozdzielają przeglądanie, zarządzanie i dane, a każde działanie jest sprawdzane na serwerze.
Instalacja
- Pobierz archiwum modułu i zainstaluj je w Moduły > Menedżer modułów albo umieść folder
wepresta_seo_auditw katalogumodulessklepu. - Zainstaluj moduł. Instalacja tworzy tabele modułu i jego pozycję w menu.
- Otwórz stronę konfiguracji i aktywuj licencję. Bez ważnej licencji moduł się wyłącza i nie serwuje przekierowań ani dziennika błędów 404.
- Otwórz moduł z menu Moduły lub, w zależności od wersji, z menu WePresta.
Moduł nie dodaje plików CSS ani JavaScriptu do witryny. Serwuje przekierowania, adresy bez identyfikatora, dziennik błędów 404 i kanał RSS ze sklepu, bez zmiany szablonu.
Pierwsza konfiguracja
- Status: sprawdź licencję i włącz moduł.
- Skanowanie: wybierz głębokość, limit stron, opóźnienie między żądaniami, limit czasu i współbieżność. Domyślne wartości skanują do 2000 stron, z 250 ms między żądaniami i dwoma równoczesnymi żądaniami.
- Progi: dostosuj długość tytułów i opisów, poziom podobieństwa i liczbę słów, poniżej której strona jest uznawana za ubogą.
- Uruchom pierwsze skanowanie ze strony Skanowanie. Śledź postęp, a potem otwórz plan naprawy.
- Ruch: zaimportuj plik CSV Search Console, aby uporządkować priorytety według kliknięć. Oczekiwane nagłówki są wstępnie wypełnione.
- Harmonogram: włącz skanowanie codzienne, tygodniowe lub miesięczne oraz raport e-mailem. Bez zadania zaplanowanego skanowanie trwa tylko dopóki strona modułu pozostaje otwarta.
Strona konfiguracji grupuje też sekcje Dziennik błędów 404, Przekierowania, Kanał RSS, Raport dla klienta i Dane. Dziennik błędów 404 i przekierowania są domyślnie włączone; kanał RSS jest wyłączony.
Codzienne użycie
Rano. Otwórz pulpit: priorytety ostatniego skanowania są uporządkowane według wyniku. Zacznij od problemów krytycznych i od stron, które mają kliknięcia.
Po zmianie katalogu. Uruchom nowe skanowanie. Porównanie z poprzednim pokazuje, co jest nowe, co naprawione i co wróciło; plan aktualizuje się bez utraty statusów i notatek.
Gdy adres przestaje działać. Dziennik błędów 404 zgłasza go z sugerowanym celem. Utwórz przekierowanie i sprawdź, czy jest serwowane.
Dla klienta. Wygeneruj raport dla klienta w jego języku, z twoim logo, i wydrukuj go lub zapisz w PDF. Pokazuje problemy według wagi i rodziny, a nie tylko listę stron.
W multisklepie. Każdy sklep ma własne skanowania i ustawienia. Widok porównania stawia sklepy z grupy obok siebie.
Zastosowania
Sklep, który zmienia szablon lub adresy. Redesign przenosi kategorie i karty produktów. Skanowanie wskazuje błędy 404 i martwe linki, menedżer przekierowań przejmuje stare adresy, a adresy bez identyfikatora czynią nowe czytelniejszymi.
Duży katalog. Tysiące kart produktów dają powtórzone tytuły, obrazy bez tekstu alternatywnego i zbyt krótkie opisy. Plan grupuje te problemy według rodziny i wagi, a reguły wykluczeń pozwalają nie zajmować się ręcznie tym, co zostało przyjęte celowo.
Agencja lub konsultant. Datowane skanowanie, porównanie i raport dla klienta dokumentują stan początkowy, poprawki i to, co zostało. Raport powstaje w języku klienta.
Firma wielojęzyczna i multisklepowa. Każdy język ma własne skanowanie i adresy. Porównanie sklepów pokazuje, gdzie wracają te same błędy.
Wymagania i ograniczenia
- PrestaShop 1.7.8, 8.2+ i 9.0+; wersje 8.0 i 8.1 nie są obsługiwane. PHP 7.4 lub nowszy.
- Skanowanie czyta serwowany HTML, bez JavaScriptu: treści i linki dodawane w przeglądarce nie są widoczne.
- Przy domyślnych ustawieniach około 1000 stron zajmie 10–20 minut; domyślny limit to 2000 stron na skanowanie. Bez zadania zaplanowanego skanowanie posuwa się tylko dopóki strona modułu pozostaje otwarta.
- Wskaźniki wydajności są liczone na podstawie HTML, a nie Core Web Vitals.
- Linki zewnętrzne nie są domyślnie sprawdzane; opcja istnieje, ale wydłuża skanowanie i wychodzi poza domenę sklepu. Skanowane są tylko hosty sklepu.
- Moduł nie generuje meta tagów, danych strukturalnych ani sitemapy i nie przepisuje tekstów alternatywnych: sprawdza je i wskazuje, co poprawić.
- robots.txt jest wspólny dla wszystkich sklepów. PrestaShop może go wygenerować ponownie własnym narzędziem; moduł wykrywa nadpisanie i proponuje przywrócenie twojej wersji, ale nie może mu zapobiec.
- Bez ważnej licencji moduł się wyłącza: przekierowania przestają być serwowane, dziennik błędów 404 się zatrzymuje, adresy bez identyfikatora wracają do formatu PrestaShop, a kanał RSS odpowiada 404. Dane pozostają, a wszystko wraca po odnowieniu licencji.
- Przy odinstalowaniu dane są usuwane, jeśli zaznaczysz odpowiednią opcję; wiersze
PS_ROUTE_*odłożone na bok są przywracane, a robots.txt nie jest zmieniany.
FAQ
Czy moduł zmienia moje strony lub treści?
Nie. Czyta HTML w postaci serwowanej i nigdy nie zapisuje w stronach, kartach produktów ani kategoriach. Jego jedyne zapisy dotyczą dziennika błędów 404, reguł przekierowań, konfiguracji adresów, robots.txt i kanału RSS; żadna strona nie jest modyfikowana. Żaden meta tag ani tekst nie jest przepisywany automatycznie.
Czy potrzebne jest konto Google lub klucz API?
Nie. Nie potrzeba konta zewnętrznego ani klucza API. Priorytety według ruchu korzystają z pliku CSV Search Console, który importujesz; oczekiwane nagłówki są wstępnie wypełnione.
Czy moduł mierzy Core Web Vitals?
Nie. Rodzina „Wskaźniki wydajności HTML” patrzy na zawartość i wagę strony, a nie na dane terenowe Google. Core Web Vitals i rzeczywista szybkość wymagają osobnego narzędzia; moduł wskazuje natomiast ciężkie strony i elementy.
Ile trwa skanowanie?
Przy domyślnych ustawieniach około 1000 stron zajmie 10–20 minut, w ramach domyślnego limitu 2000 stron. Bez zadania zaplanowanego skanowanie trwa, dopóki strona modułu pozostaje otwarta; z zadaniem zaplanowanym działa w tle. Opóźnienie między żądaniami i współbieżność są ustawieniami.
Czy moduł działa w multisklepie?
Tak. Skanowanie jest wykonywane dla każdego sklepu i języka, z własną historią i porównaniem. Sklepy w grupie można porównywać w osobnym widoku, a ustawienia skanowania należą do każdego sklepu.
Czy PrestaShop może nadpisać robots.txt?
Tak. Plik jest wspólny dla wszystkich sklepów, a narzędzie generowania PrestaShop może go nadpisać. Moduł wykrywa nadpisanie i proponuje przywrócenie ostatniej zapisanej wersji; nie może zapobiec regeneracji.
Co się stanie, gdy licencja wygaśnie?
Moduł wyłącza się w danych sklepach: przekierowania przestają być serwowane, dziennik błędów 404 się zatrzymuje, adresy bez identyfikatora wracają do formatu PrestaShop, a kanał RSS odpowiada 404. Tabele, ustawienia i dane pozostają, a wszystko wraca po odnowieniu licencji.
Czy przekierowania i robots.txt zostają po odinstalowaniu?
wiersze PS_ROUTE_* odłożone na bok są przywracane, a robots.txt nie jest zmieniany. Tabele i ustawienia modułu są usuwane tylko wtedy, gdy zaznaczysz opcję usunięcia danych; inaczej pozostają.
Czy moduł generuje meta tagi lub dane strukturalne?
Nie. Sprawdza istniejące tagi i wskazuje braki, ale nie generuje tytułów, opisów, JSON-LD ani sitemapy. Tym zajmują się moduły uzupełniające z tej samej serii, takie jak SEO Meta Automator i Schema Pro.
W jakich językach jest dostępny?
Interfejs, plan naprawy i raport e-mail są dostępne po francusku, angielsku, hiszpańsku, włosku i polsku. Raport dla klienta powstaje w języku raportu, a sklep wielojęzyczny ma skanowanie dla każdego języka.
Wsparcie
Aby uzyskać pomoc, napisz do nas z obszaru klienta lub na adres mail@wepresta.shop, zależnie od opcji wsparcia w twoim wariancie.
Zanim napiszesz, przygotuj:
- wersję PrestaShop i PHP;
- wersję modułu;
- adres, którego dotyczy problem, lub nazwę ekranu;
- zrzut ekranu i dokładny komunikat.
Changelog
Wersja 1.0.0
- Skanuje sklep jak robot: strona główna, sitemap, linki wewnętrzne i katalog, w serwowanym HTML, bez JavaScriptu.
- Wykonuje skanowanie dla każdego sklepu i języka, z datowaną historią i porównaniem: problemy nowe, naprawione, trwałe i otwarte ponownie.
- Sprawdza 124 punkty SEO w 19 rodzinach, ze stroną i elementem, którego dotyczą.
- Zapisuje problemy w planie naprawy z wagą, wpływem, nakładem, statusem, notatkami i historią oraz sprawdza poprawkę przy kolejnym skanowaniu.
- Ustala priorytety planu na podstawie ruchu importowanego z pliku CSV Search Console.
- Zapisuje błędy 404 bez adresu IP, sugeruje cel i tworzy przekierowanie jednym kliknięciem.
- Obsługuje przekierowania dokładne i według wyrażeń regularnych, w 301, 302 lub 303, z priorytetami, kontrolą pętli i łańcuchów oraz importem i eksportem CSV.
- Oferuje adresy bez identyfikatora dla produktów, kategorii, marek i stron CMS, z symulacją, kontrolą kolizji, przekierowaniem 301 ze starych adresów i przywróceniem.
- Edytuje robots.txt z testerem, podglądem, wersjami i przywracaniem.
- Publikuje kanał RSS nowości w każdym języku.
- Pokazuje pulpit, eksporty CSV i JSON oraz raport dla klienta do wydruku w języku raportu.
- Planuje skanowania codziennie, co tydzień lub co miesiąc, z raportem e-mailem.
- Obsługuje multisklep, porównanie sklepów i uprawnienia pracowników.
- Udostępnia interfejs w pięciu językach.

Powiązane artykuły
Audyt SEO PrestaShop: błędy 404, martwe linki i plan naprawy
Moduł Błędy SEO skanuje sklep w serwowanym HTML, porządkuje problemy według wagi i ruchu, a potem naprawia 404, przekierowania, adresy i robots.txt.