Audyt SEO PrestaShop: błędy 404, martwe linki i plan naprawy
Moduł Błędy SEO skanuje sklep w serwowanym HTML, porządkuje problemy według wagi i ruchu, a potem naprawia 404, przekierowania, adresy i robots.txt.
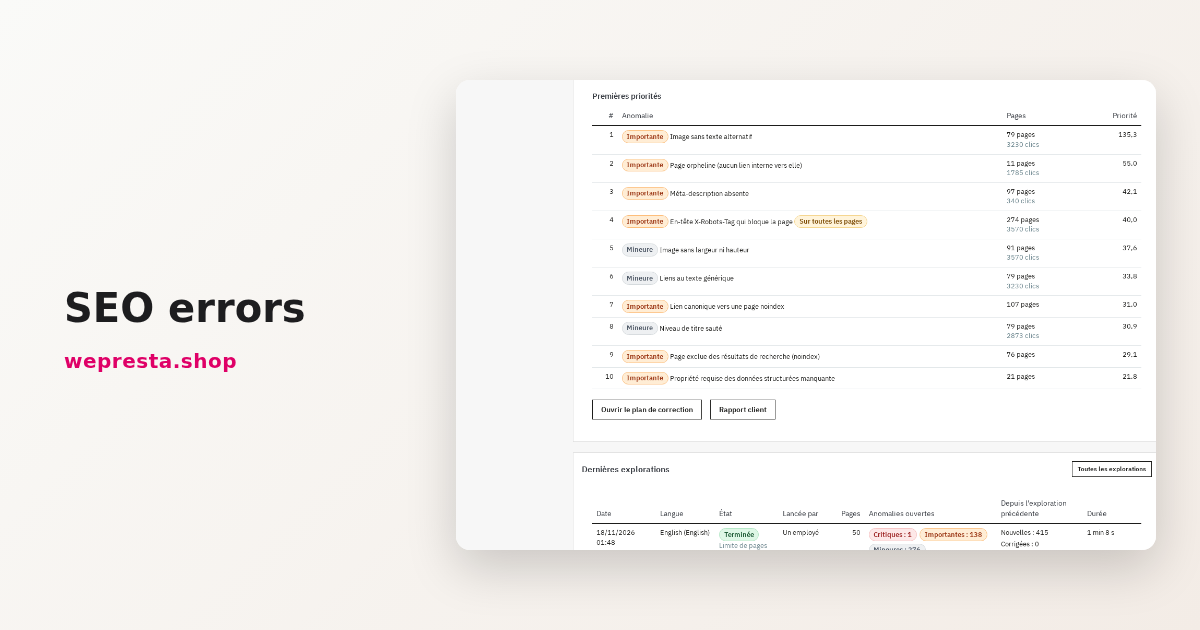
Karta produktu, która odpowiada 404, ten sam tytuł w trzech kategoriach, znacznik kanoniczny wskazujący nieistniejący adres: tych błędów nie widać w panelu administracyjnym. Są w HTML, który otrzymuje wyszukiwarka. Błędy SEO skanuje sklep jak robot wyszukiwarki, porządkuje problemy według wagi i ruchu, a potem daje narzędzia do naprawy najczęstszych przyczyn: dziennik błędów 404, przekierowania, adresy bez identyfikatora i robots.txt.
Moduł wykrywa i naprawia problemy techniczne; nie przepisuje tekstów ani meta znaczników. Oto dla kogo jest przeznaczony i jak czytać jego plan naprawy.
Dla kogo jest ten audyt SEO, a dla kogo nie?
Jest dla sprzedawcy, który sam prowadzi katalog kilkuset kart, oraz dla agencji przejmującej istniejący sklep. Nie jest dla kogoś, kto szuka narzędzia przepisującego znaczniki za niego.
Trzy sytuacje czynią go użytecznym. Katalog skopiowany od dostawcy przychodzi z identycznymi tytułami, opisami i obrazami bez tekstu alternatywnego. Zmiana szablonu lub adresów zostawia stare URL-e z błędem 404, a linki wewnętrzne prowadzą do przeniesionych stron. Agencja przejmująca sklep potrzebuje datowanego obrazu stanu przed dotknięciem kodu.
Odwrotnie, sklep wizytówka z dziesięcioma stronami nie potrzebuje automatycznego audytu, a sprzedawca, który chce tylko poprawić meta znaczniki, lepiej wybierze moduł do pisania. Audyt czyta i zgłasza; poprawianie tekstów pozostaje twoją decyzją. Sklepy wielojęzyczne i wielosklepowe też korzystają: każdy sklep i każdy język ma własne skanowanie i historię.
Jak skanować sklep tak, jak robi to wyszukiwarka?
Rozpocznij skanowanie w sekcji Skanowania. Moduł wychodzi od strony głównej, sitemapy, linków wewnętrznych i katalogu, a potem czyta serwowany HTML bez uruchamiania JavaScriptu.
Ta metoda odtwarza HTML, który otrzymuje wyszukiwarka przed uruchomieniem jakiegokolwiek skryptu. Treści dodane wyłącznie przez skrypt w przeglądarce lub linki budowane po stronie klienta nie pojawiają się w audycie, który czyta serwowany HTML. Google może część z nich wyrenderować; audyt ich nie widzi.
Domyślne ustawienia skanują do 2 000 stron, z odstępem 250 ms między żądaniami i dwoma równoczesnymi żądaniami. Około 1 000 stron zajmuje 10 do 20 minut. Te wartości można zmienić w sekcji Skanowanie w konfiguracji: głębokość, maksymalna liczba skanowanych stron, pauza między żądaniami, czas dozwolony na stronę i równoległe żądania.
Skanowanie odbywa się osobno dla każdego sklepu i języka, z datowaną historią. Porównanie z poprzednim skanowaniem dzieli problemy na cztery grupy: nowe, naprawione, nadal obecne i powracające. Bez zadania zaplanowanego skanowanie posuwa się tylko wtedy, gdy strona modułu pozostaje otwarta; z harmonogramem pracuje w tle.
Jak znaleźć błędy 404 i martwe linki?
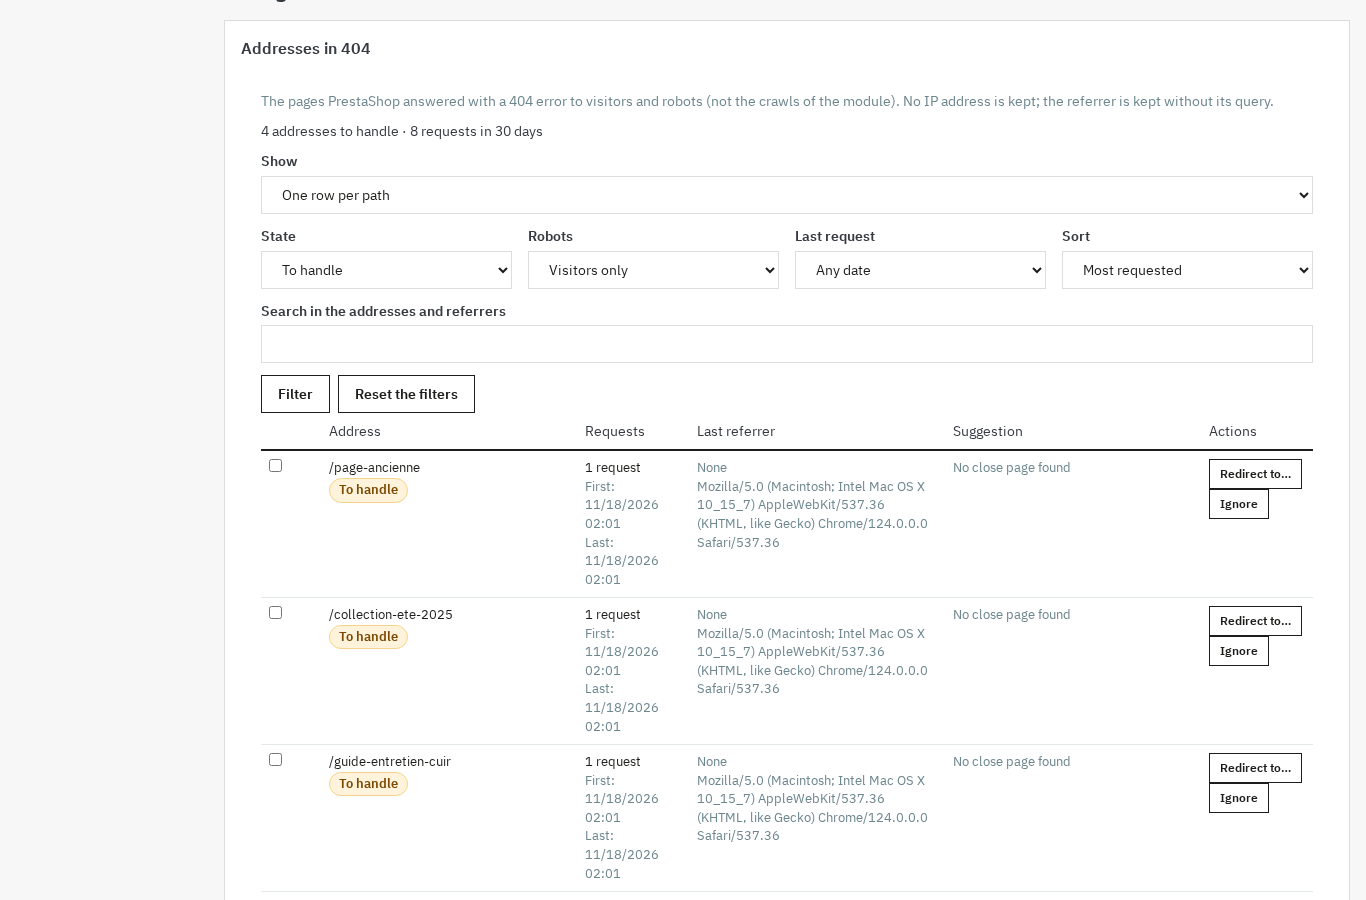
Dziennik błędów 404 wymienia adresy, na które PrestaShop odpowiedział błędem 404, z liczbą żądań i sugerowaną pobliską stroną. Przekierowanie tworzy się z wiersza, bez opuszczania ekranu.
Dziennik zapisuje żądania odwiedzających i robotów, bez przechowywania adresu IP; referrer jest zachowywany bez zapytania. Listę ustawia się przez Pokaż (jeden wiersz na ścieżkę lub na adres), Status, Roboty i Ostatnie żądanie, a następnie Sortowanie. Gdy znaleziona jest pobliska strona, Przekieruj do sugestii tworzy przekierowanie w jednym kliknięciu. Przekieruj do… otwiera regułę; Ignoruj usuwa adres z wierszy do obsługi.
Menedżer przekierowań przyjmuje reguły dokładne i wyrażenia regularne, w kodach 301, 302 lub 303. Sprawdza pętle i łańcuchy, obsługuje priorytety i import lub eksport CSV. Reguły są serwowane przed renderowaniem strony.
Skanowanie zgłasza też martwe linki znalezione na stronach, łańcuchy przekierowań i linki prowadzące do przekierowanego adresu. Dokumentacja modułu opisuje kolumny i formaty importu.
Jak wykryć duplikaty tytułów i meta opisów?
Skanowanie porównuje tytuły, opisy i H1 stron indeksowalnych, a potem zgłasza duplikaty, brakujące wartości i długości poza progiem. Każdy problem wskazuje stronę i element, którego dotyczy.
Te ustalenia należą do rodziny Tytuły, opisy i nagłówki. Progi ustawia się w sekcji Progi w konfiguracji: długość tytułów i opisów, podobieństwo stron prawie duplikatów oraz najmniejsza liczba słów strony.
Moduł nie przepisuje żadnego znacznika. Pokazuje oryginalny tytuł, jego długość i podgląd tego, jak strona wygląda w wynikach wyszukiwania. Poprawkę wprowadza się w karcie produktu, w kategorii albo za pomocą modułu Automatyczne meta tagi SEO, który stosuje szablony według typu strony.
Rodzina Zduplikowana i uboga treść obejmuje inny przypadek: dwie prawie identyczne karty, na przykład opis dostawcy skopiowany na dwadzieścia referencji. Stopień podobieństwa wywołuje ostrzeżenie; napisanie tekstu nadal należy do ciebie. W przypadku danych strukturalnych moduł sprawdza JSON-LD i zgłasza braki; Schema Pro je generuje.
Jak poprawić adresy i robots.txt?
Sekcja Adresy bez identyfikatora usuwa numery z URL-i produktów, kategorii, marek i stron CMS, po symulacji, która pokazuje kolizje. Sekcja robots.txt edytuje plik z testerem adresów i wersjami.
Adres taki jak /12-niebieska-koszula staje się /niebieska-koszula. Symulacja odrzuca adres już zajęty, a kontrola na żywo sprawdza wynik po zastosowaniu. Stare adresy odpowiadają wtedy kodem 301, a przywrócenie cofa konfigurację adresów PrestaShop.
Dwa ograniczenia. Kod języka pozostaje w adresie, gdy aktywne są co najmniej dwa języki; usunięcie go wymagałoby zmiany rdzenia PrestaShop. Przywrócenie adresów nie przywraca robots.txt.
Edytor robots.txt pokazuje podgląd, testuje adres względem reguł, zachowuje wersje i pozwala wrócić do wcześniejszej. Plik jest fizyczny i wspólny dla wszystkich sklepów instalacji. Jeśli PrestaShop go wygeneruje ponownie, moduł wykryje nadpisanie i zaproponuje przywrócenie twojej wersji, ale nie może temu zapobiec.
Moduł sprawdza też, czy sitemapa istnieje i jest spójna, ale jej nie generuje.
Jak uporządkować poprawki i śledzić ich status?
Każdy problem otrzymuje wagę, wpływ, nakład pracy, status, notatki i historię. Plan naprawy porządkuje je według punktacji, a następne skanowanie sprawdza, czy poprawka się utrzymała.
Wagi są trzy: krytyczna, ważna i drobna. Status wybiera się w wierszu: do naprawy, w toku, naprawiony lub ignorowany. Problem ignorowany wymaga powodu, a reguła ignorowania nie pokazuje go przy każdym skanowaniu. Problem, który znika, przechodzi na naprawiony; jeśli wróci, otwiera się ponownie.
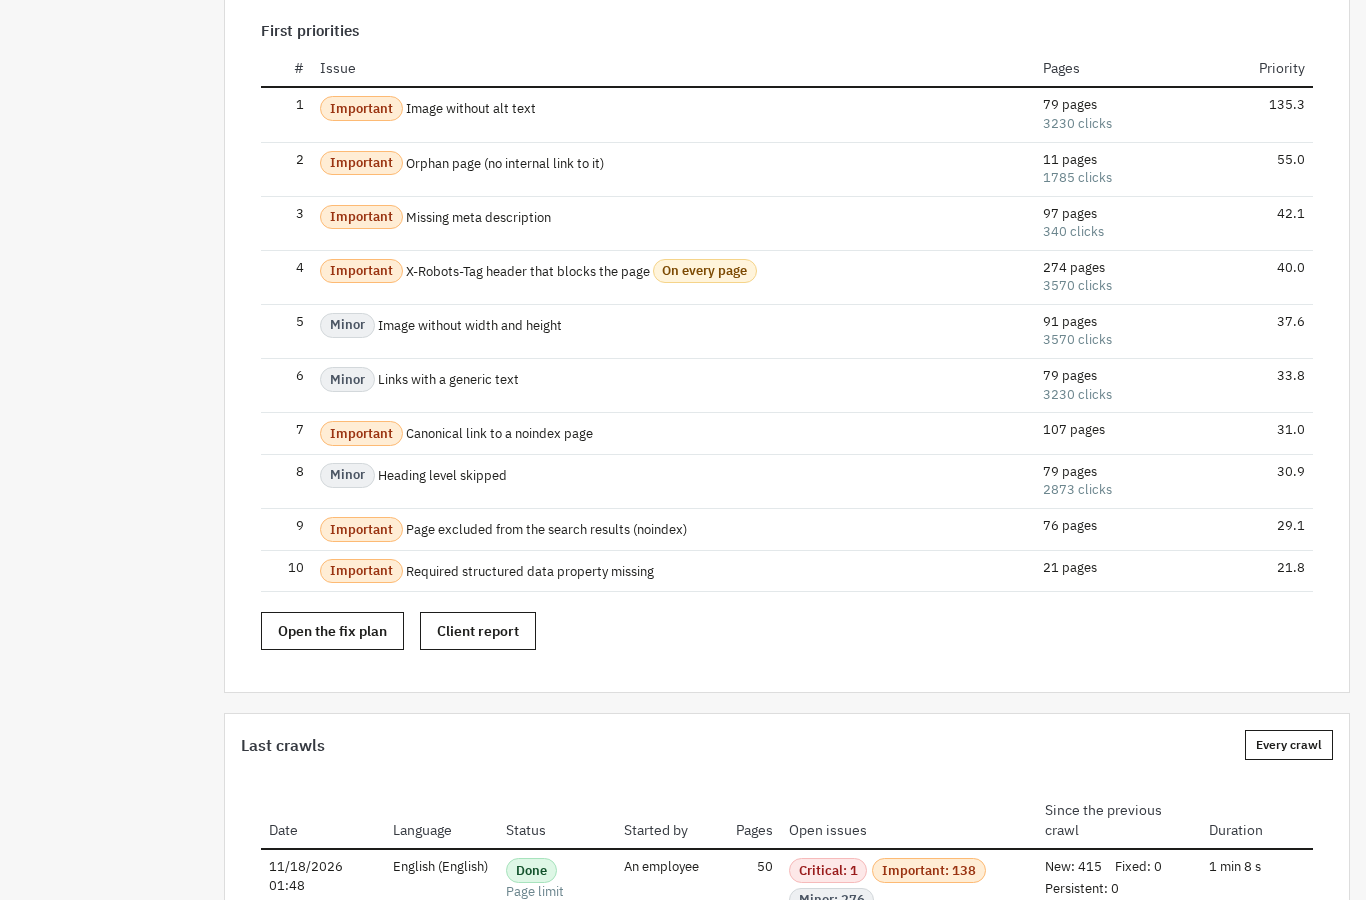
Punktacja priorytetu rośnie wraz z ruchem strony. Zaimportuj CSV z Search Console w sekcji Ruch: ekran dopasowania kolumn pojawia się zawsze i jest wstępnie wypełniony. Symulacja pokazuje rozpoznane i nieprawidłowe wiersze przed importem.
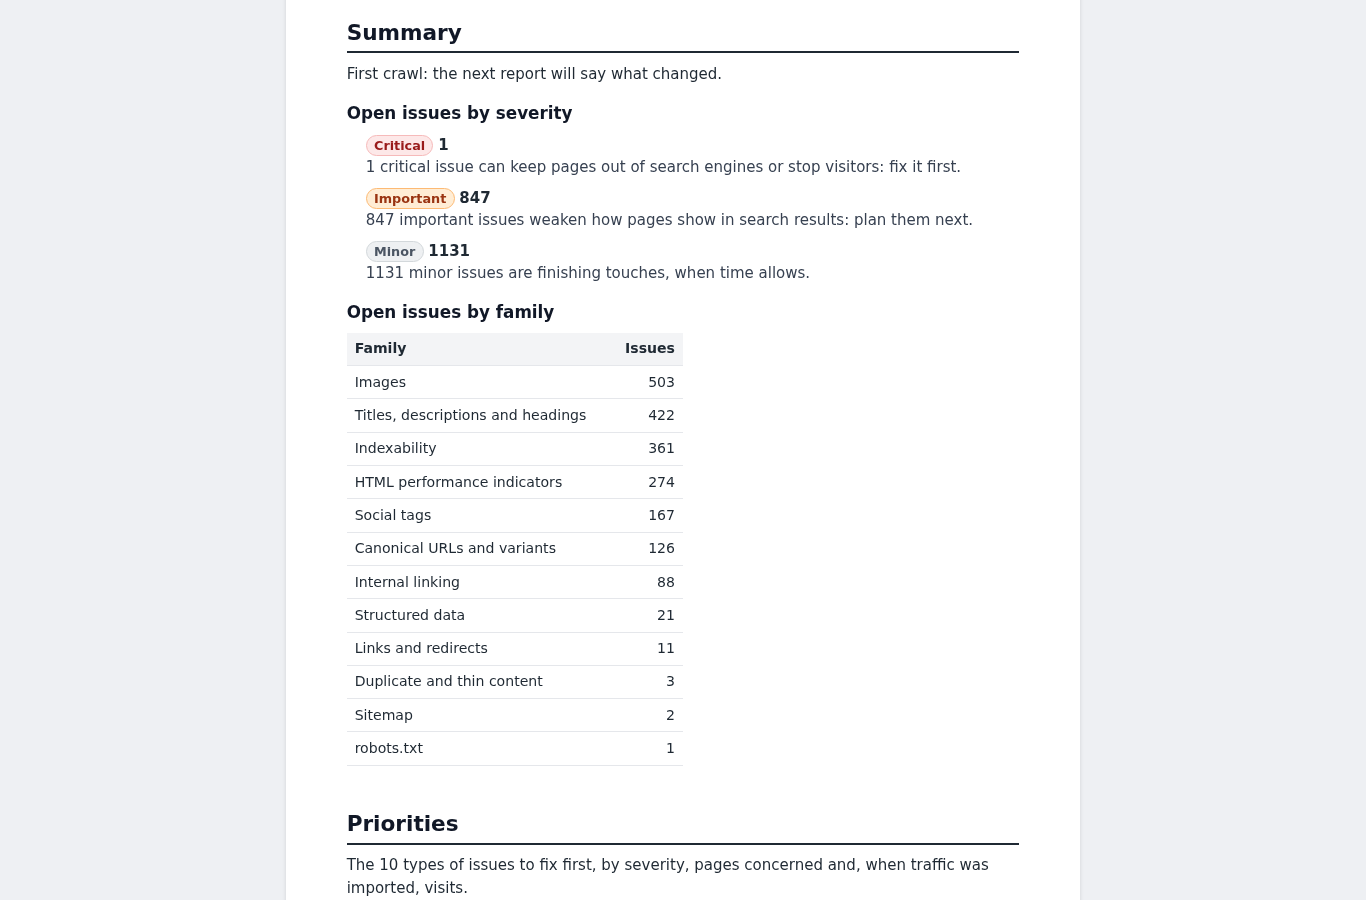
Dla klienta wygeneruj raport w jego języku, z twoim logo. Zawiera podsumowanie, otwarte problemy według wagi, tabelę według rodzin, priorytety i plan działania; potem można go wydrukować lub zapisać w PDF.
Zaplanowane skanowanie może działać codziennie, co tydzień lub co miesiąc, z raportem e-mail.
Jak zainstalować moduł i czego nie robi?
Zainstaluj archiwum w sekcji Moduły > Menedżer modułów, aktywuj licencję, a potem otwórz moduł z menu Moduły lub WePresta. Nie przepisuje tekstów ani meta znaczników i nie generuje sitemapy.
Instalacja
- Pobierz archiwum i zainstaluj je w sekcji Moduły > Menedżer modułów.
- Zainstaluj moduł: instalacja tworzy jego tabele i pozycję w menu.
- Otwórz stronę konfiguracji i aktywuj licencję. Bez ważnej licencji moduł się wyłącza i nie serwuje przekierowań ani dziennika błędów 404.
- Otwórz moduł z menu Moduły lub, w zależności od wersji, z menu WePresta.
Moduł działa na PrestaShop 1.7.8, 8.2+ i 9.0+, z PHP 7.4 lub nowszym. Wersje 8.0 i 8.1 nie są obsługiwane.
Ustawienia na start
Strona konfiguracji ma dziewięć sekcji: Status, Skanowanie, Harmonogram i raport e-mail, Progi, Dziennik błędów 404, Przekierowania, Kanał RSS, Raport dla klienta i Dane. Sprawdź licencję w Status, zachowaj domyślne ustawienia i rozpocznij skanowanie w sekcji Skanowania.
Czego nie robi
- Nie pisze w twoich stronach: ani tytułów, ani opisów, ani danych strukturalnych, ani tekstów alternatywnych, ani sitemapy. Sprawdza i wskazuje, co poprawić.
- Nie mierzy Core Web Vitals: rodzina Wskaźniki wydajności HTML patrzy na wagę i liczbę elementów strony, a nie na dane terenowe. Za cache odpowiada Cache Pro na innym poziomie.
- Nie stosuje się do robots.txt podczas skanowania: czyta go i zgłasza blokady, bo audyt dotyczy twojego sklepu.
- Nie sprawdza linków zewnętrznych domyślnie; opcja istnieje i wydłuża skanowanie.
- Bez ważnej licencji wyłącza się: przekierowania przestają działać, dziennik błędów 404 staje, adresy bez identyfikatora wracają do formatu PrestaShop, a kanał RSS odpowiada 404. Dane zostają i wszystko wraca po walidacji licencji.
- Przy odinstalowaniu wiersze PS_ROUTE_* odłożone na bok wracają, a robots.txt nie jest zmieniany. Tabele znikają tylko po zaznaczeniu opcji usunięcia.
Audyt nie gwarantuje żadnej pozycji w wynikach wyszukiwania. Dokumentuje stan i pokazuje, co zmieniło się między dwoma skanowaniami. Karta modułu podaje warianty i wymagania.
Najczęściej zadawane pytania
Czy moduł poprawia zduplikowane tytuły i opisy?
Jak dziennik błędów 404 znajduje zepsute strony?
Czy moduł sprawdza, czy moje strony są zaindeksowane w Google?
Czy moduł mierzy rzeczywistą szybkość stron?
Czy działa w sklepie wielojęzycznym?
Produkty w tym artykule
Błędy SEO: pełny audyt sklepu, martwe linki i plan naprawy
Skanuje sklep jak wyszukiwarka: strona główna, sitemap, linki wewnętrzne i katalog, bez JavaScriptu Wykonuje 124...
Automatyczne meta tagi SEO: tytuły, opisy i słowa kluczowe dla całego katalogu
Szablony dla każdego typu strony i języka dla meta tytułów, opisów meta i słów kluczowych produktów, kategorii,...
Schema Pro - Complete JSON-LD Structured Data & Rich Snippets
Product, ProductGroup, Organization, WebSite, BreadcrumbList, FAQPage, CollectionPage i ItemList tworzone z...
Cache Pro — Full Page Cache with Brotli, Warm-Up & AJAX
Pamięć podręczna pełnych stron: zapisane strony są wysyłane, zanim PrestaShop je zbuduje, bez żadnego zapytania...
Przeczytaj także
Jak zbierać i publikować opinie klientów w PrestaShop
Od formularza opinii po prośby wysyłane po dostawie, przez moderację, publiczne odpowiedzi i znaczniki JSON-LD: jak moduł Opinie o produktach i sklepie organizuje…
Logowanie społecznościowe w PrestaShop: Google i Facebook
Zakładanie konta spowalnia zamówienie. Social Login dodaje przyciski Google, Facebook i Apple do logowania i zamówienia, z jednym adresem zwrotnym, testem dostawcy i…
Jak utworzyć popup w PrestaShop i mierzyć konwersje
Praktyczny przewodnik: jak zbudować popup w PrestaShop w edytorze przeciągnij i upuść, wybrać wyzwalacz, targetować odwiedzających, śledzić konwersje i utrzymać moduł…